

티스토리 뷰
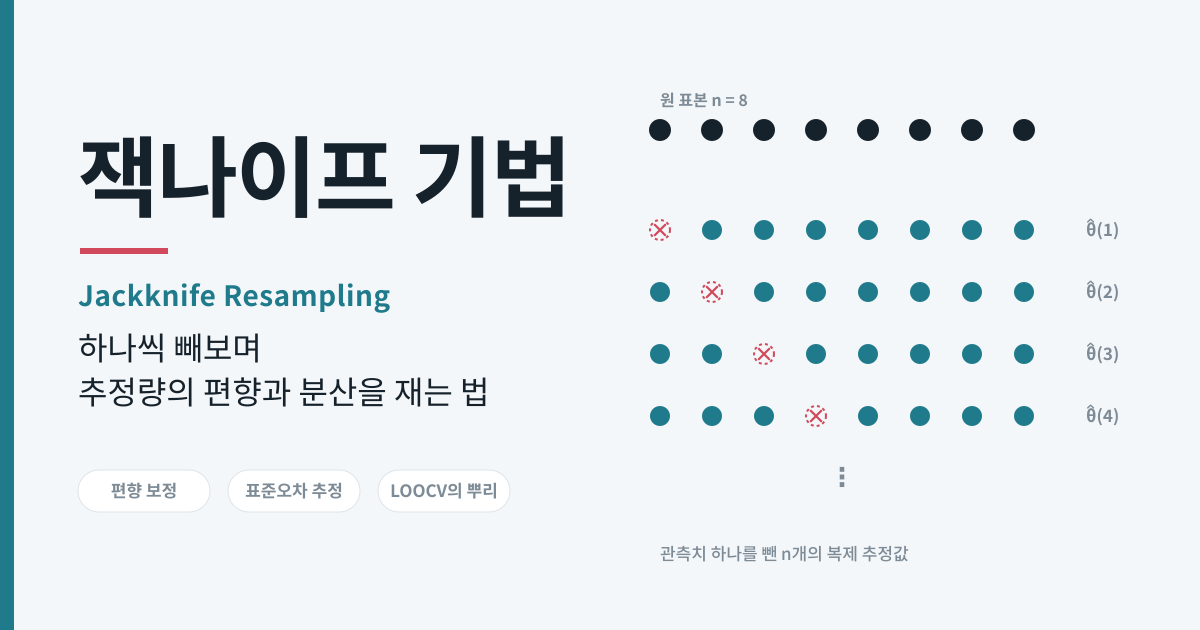
표본이 30개밖에 없는데 상관계수의 표준오차를 보고해야 한다면? 지니계수의 신뢰구간이 필요한데 분산 공식이 교과서에 없다면? 이럴 때 가장 먼저 꺼내 드는 도구가 잭나이프(Jackknife)입니다.
이름부터가 맥가이버칼입니다. 하나의 작은 도구로 편향도 잡고 표준오차도 재는, 만능은 아니지만 웬만한 상황에서 바로 쓸 수 있는 기법이라는 뜻이죠. 1949년 Quenouille가 편향 보정용으로 제안했고, 1958년 Tukey가 여기에 분산 추정 기능을 붙이면서 지금의 이름이 붙었습니다.
🎯 한 줄로 말하면
어느 쪽으로 쏠리는지로 편향을 역산하는 재표본추출 기법
핵심은 "빼본다"입니다. 데이터를 새로 모을 수는 없으니, 가진 데이터를 조금씩 바꿔가며 추정값이 얼마나 예민하게 반응하는지를 관찰하는 겁니다. 딱 하나만 뺐는데 결과가 확 바뀐다면? 그 추정값은 믿을 만한 값이 아니라는 신호죠.
⚙️ 동작 원리: 4단계면 끝
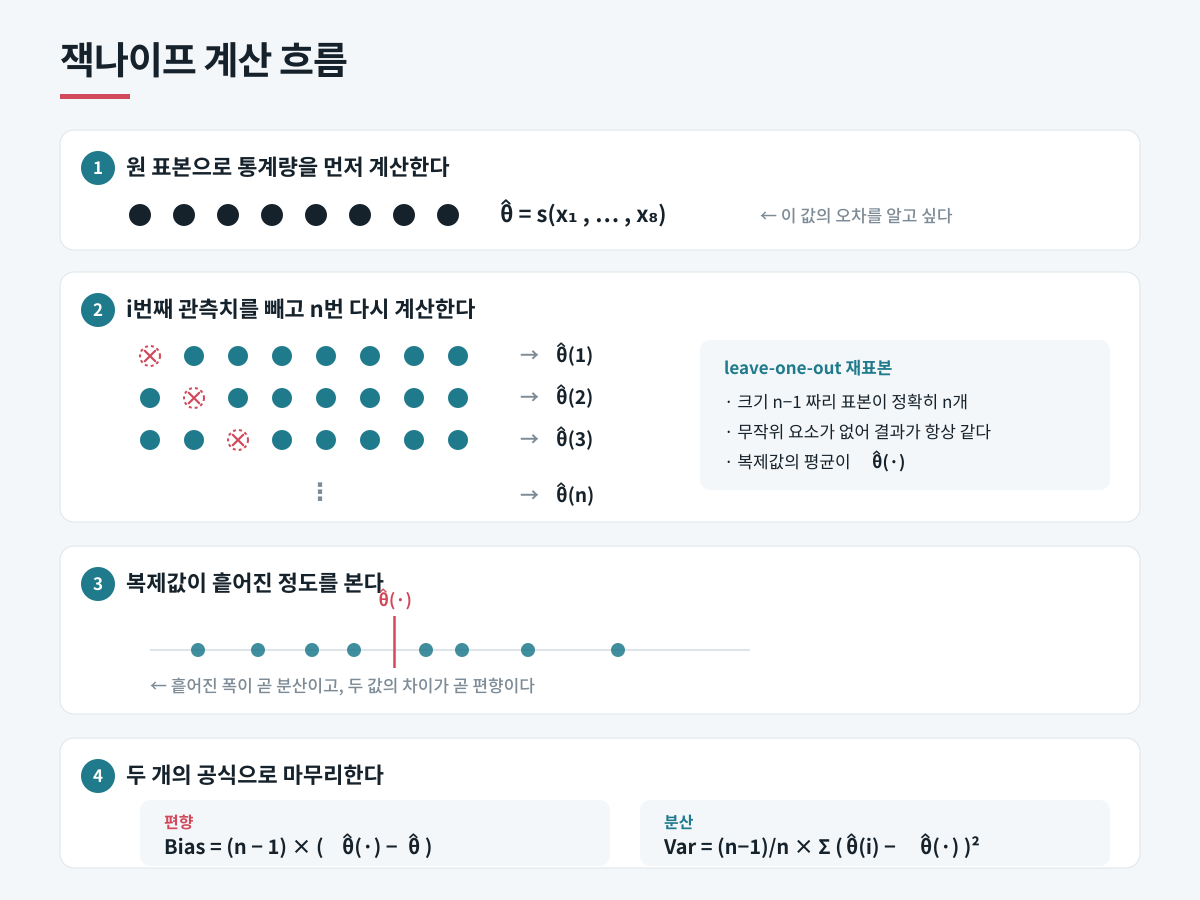
🔹 Step 1. 원 표본으로 통계량을 먼저 계산
표본 X = (x₁, …, xₙ)에서 관심 있는 통계량 θ̂ = s(X)를 구합니다. 평균일 수도, 상관계수일 수도, 회귀계수일 수도 있습니다. 잭나이프는 통계량이 무엇인지 신경 쓰지 않습니다. 계산만 가능하면 됩니다.
🔹 Step 2. i번째를 빼고 n번 다시 계산
i번째 관측치 하나를 제외한 n−1개짜리 표본으로 통계량을 다시 구합니다. 이걸 i = 1부터 n까지 반복하면 복제 추정값 θ̂₍ᵢ₎ 가 정확히 n개 생깁니다.
이 과정을 leave-one-out이라고 부릅니다. 무작위 요소가 전혀 없기 때문에, 같은 데이터라면 몇 번을 돌려도 결과가 똑같습니다.
🔹 Step 3. 복제값의 평균과 흩어짐을 본다
복제값 n개의 평균입니다. 이 값과 원래 θ̂ 의 차이가 편향의 실마리가 되고, 복제값들이 흩어진 폭이 분산의 실마리가 됩니다.
🔹 Step 4. 두 개의 공식으로 마무리
| 구분 | 공식 |
|---|---|
| 편향 추정 | Bias = (n − 1) × ( θ̂₍·₎ − θ̂ ) |
| 편향 보정값 | θ̂jack = n·θ̂ − (n − 1)·θ̂₍·₎ |
| 분산 추정 | Var = (n − 1)/n × Σ ( θ̂₍ᵢ₎ − θ̂₍·₎ )² |
leave-one-out 표본들은 서로 n−2개를 공유합니다. 거의 같은 데이터라는 뜻이죠. 그래서 복제값들의 변동이 실제보다 작게 나옵니다. 이걸 되돌려 놓는 확대(inflation) 계수입니다.
🔹 보너스: 의사값(pseudo-value) 관점
같은 계산을 이렇게 볼 수도 있습니다.
이렇게 만든 n개의 의사값을 마치 독립 관측치인 것처럼 취급하면, 평균이 곧 편향 보정된 추정값이고 표준오차는 그냥 표준편차 나누기 √n 입니다. 아무리 복잡한 통계량이라도 "평균 문제"로 바꿔주는 것, 이게 잭나이프의 실질적인 위력입니다.
🧮 진짜 되는지 직접 검증해보기
공식만 보면 미덥지 않으니, 답을 이미 아는 두 경우에 넣어봅니다.
| 적용 대상 | 잭나이프 결과 | 이론값 |
|---|---|---|
| 표본평균의 분산 | s² / n | s² / n ✅ 완전 일치 |
| MLE 분산 (1/n 로 나눈 편향 있는 추정량) | 1/(n−1) 로 나눈 형태 | 불편추정량 s² ✅ 정확히 복원 |
특히 두 번째가 인상적입니다. 우리가 통계학 첫 시간에 "왜 n이 아니라 n−1로 나누나요"라고 외웠던 그 보정을, 잭나이프는 공식을 몰라도 기계적으로 찾아냅니다. 편향의 차수를 O(1/n)에서 O(1/n²)로 줄여주기 때문입니다.
💻 파이썬으로는 10줄이면 충분
import numpy as np

def jackknife(data, stat_func):
    n = len(data)
    theta_hat = stat_func(data)
    reps = np.array([stat_func(np.delete(data, i)) for i in range(n)])
    theta_dot = reps.mean()

    bias = (n - 1) * (theta_dot - theta_hat)
    var  = (n - 1) / n * np.sum((reps - theta_dot) ** 2)

    return {"estimate":  theta_hat,
            "bias":      bias,
            "corrected": theta_hat - bias,
            "se":        np.sqrt(var)}

# 사용 예: 변동계수의 표준오차
data = np.array([12, 15, 9, 22, 18, 11, 25, 14, 17, 20])
print(jackknife(data, lambda x: x.std(ddof=1) / x.mean()))
라이브러리를 쓴다면 R은 bootstrap::jackknife(), 파이썬은 scipy.stats.bootstrap(method="BCa") 안에서 잭나이프가 이미 돌아가고 있습니다.
📌 어디에 쓰이나? — 활용 사례
| 분야 | 활용 내용 |
|---|---|
| 복잡한 추정량 | 상관계수, 비율의 비, 지니계수, 변동계수처럼 분산 공식이 없거나 유도가 까다로운 경우 |
| 복합표본 조사 | 층화·군집 설계에서 replicate weight(JK1, JK2, JKn) 방식으로 분산 추정. 국민건강영양조사, NHANES, PISA 등 공공 마이크로데이터의 표준 절차 |
| 회귀 진단 | DFBETA, DFFITS, Cook's D, PRESS 통계량 — 전부 leave-one-out 구조입니다. 영향점(influential point) 탐지에 사용 |
| 머신러닝 | LOOCV가 사실상 잭나이프의 예측오차 버전입니다. 최근에는 Jackknife+ 가 예측구간(conformal prediction) 생성에 활용 |
| 생물정보·계통학 | 계통수 분지의 신뢰도(branch support) 평가, 유전자 다양성 지표의 분산 추정 |
| 물리·천문학 | 관측 블록을 하나씩 제외하며 계통오차(systematic error)가 특정 구간에서 오는지 검증 |
| 보안·운영 지표 | 탐지율, 오탐률처럼 표본이 적은 지표에서 특정 대상 하나가 결과를 좌우하는지 점검 |
🔍 부트스트랩과는 뭐가 다른가?
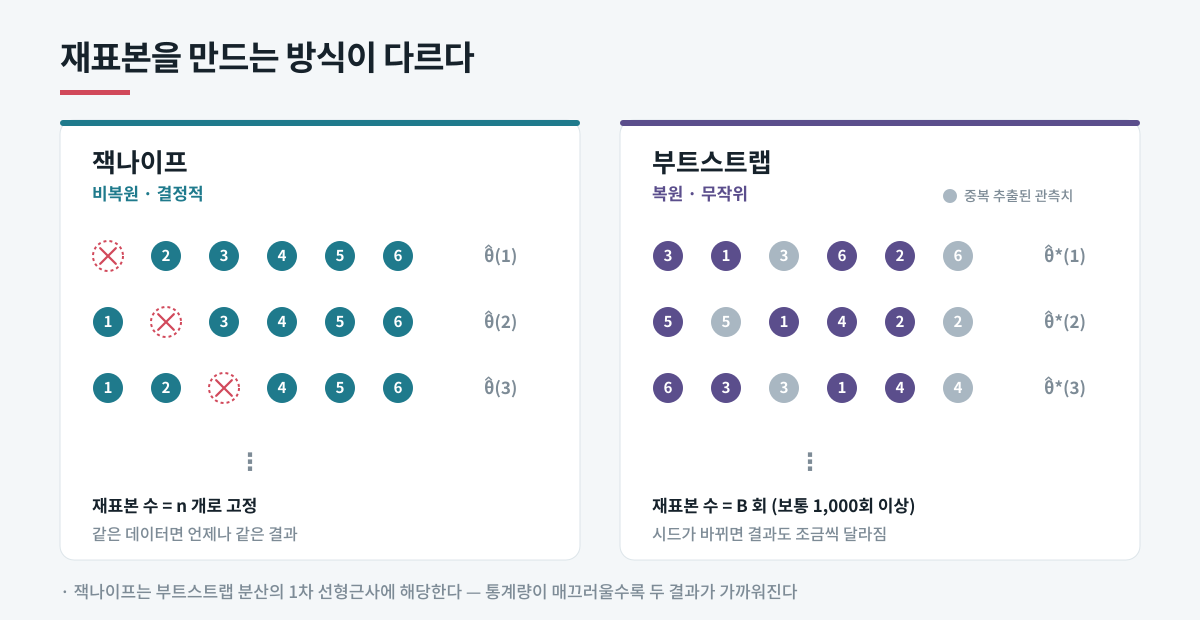
재표본추출 하면 보통 부트스트랩부터 떠올립니다. 가장 많이 받는 질문이기도 하고요.
| 구분 | 잭나이프 | 부트스트랩 |
|---|---|---|
| 재표본 방식 | 하나씩 제외 (비복원, 결정적) | 복원추출 무작위 B회 |
| 계산 횟수 | ✅ 정확히 n회 | ⚠️ 보통 1,000 ~ 10,000회 |
| 재현성 | ✅ 항상 동일 | ⚠️ 시드에 따라 변동 |
| 적용 범위 | ❌ 평활 통계량 한정 | ✅ 훨씬 넓음 |
| 신뢰구간 | ⚠️ 정규근사 위주로 제한적 | ✅ percentile, BCa 등 다양 |
⚠️ 함정: 잭나이프가 통하지 않는 경우
여기가 가장 중요합니다. 잭나이프는 아무 통계량에나 쓸 수 있는 기법이 아닙니다.
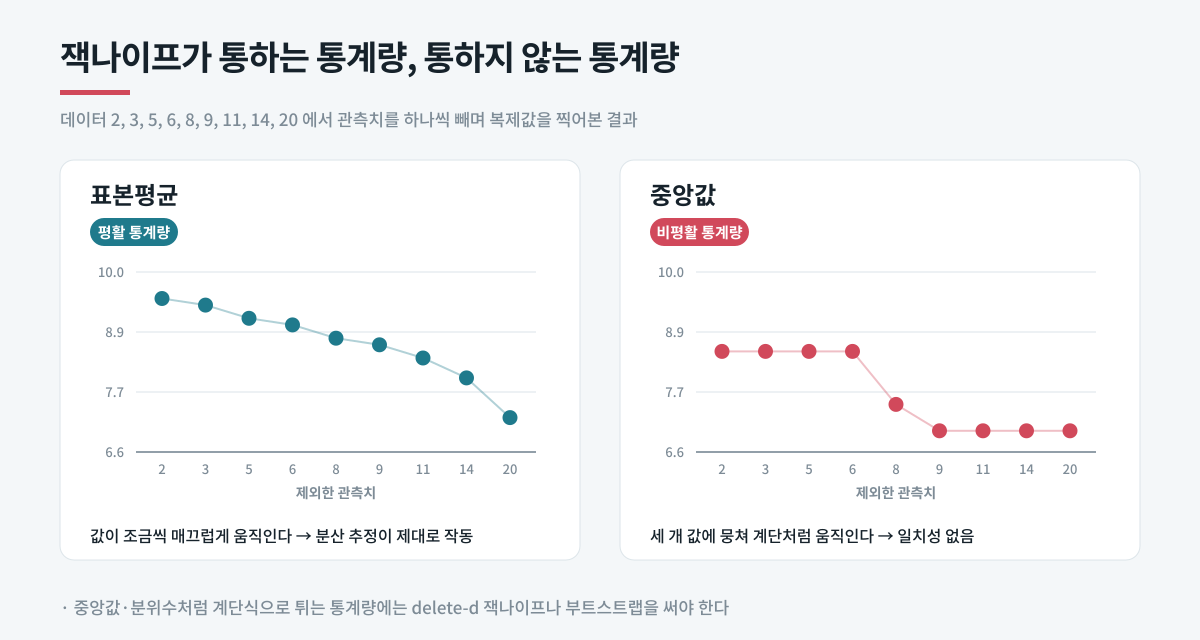
데이터 2, 3, 5, 6, 8, 9, 11, 14, 20 에서 관측치를 하나씩 빼며 복제값을 찍어본 결과입니다.
- 표본평균은 9.50 → 9.375 → 9.125 → … → 7.25 로 매끄럽게 움직입니다.
- 중앙값은 8.5 (4번) → 7.5 (1번) → 7.0 (4번), 딱 세 개 값에만 뭉칩니다.
중앙값처럼 관측치 하나를 빼면 값이 계단식으로 튀는 통계량을 비평활(non-smooth) 통계량이라고 합니다. 이런 통계량에 잭나이프를 쓰면 표본 크기를 아무리 키워도 분산 추정값이 참값으로 수렴하지 않습니다(일치성 없음). 계산은 그냥 돌아가고 숫자도 예쁘게 나오기 때문에, 모르고 쓰면 잘못된 표준오차를 그대로 보고하게 됩니다.
| 통계량 | 잭나이프 적용 |
|---|---|
| 평균, 분산, 상관계수, 회귀계수 | ✅ 문제 없음 |
| 중앙값, 분위수, 최댓값 | ❌ 사용 금지 → delete-d 잭나이프 또는 부트스트랩 |
| 시계열·공간 데이터 | ⚠️ iid 가정 위반 → block jackknife |
| 군집(cluster) 표본 | ⚠️ 개별 관측치가 아니라 군집(PSU) 단위로 제외해야 함 |
delete-d 잭나이프는 1개가 아니라 d개씩 빼는 변형입니다. d/n → 0 이면서 n−d → ∞ 라는 조건을 지키면 중앙값 같은 비평활 통계량에서도 일치성을 회복할 수 있습니다.
🧩 같이 알아두면 좋은 것들
| 개념 | 내용 |
|---|---|
| 무한소 잭나이프 infinitesimal jackknife |
관측치를 완전히 빼는 대신 가중치를 아주 조금만 흔드는 방식. 영향함수(influence function) 와 직결되며, 랜덤포레스트 예측 분산 추정에도 사용됩니다. |
| Jackknife-after-bootstrap | 부트스트랩 결과 자체가 특정 관측치에 얼마나 휘둘리는지를 잭나이프로 진단합니다. |
| BCa 신뢰구간 | 부트스트랩 신뢰구간의 가속계수 a 를 잭나이프 복제값의 왜도로 계산합니다. 두 기법이 협업하는 대표 사례입니다. |
| 편향-분산 트레이드오프 | 편향 보정은 공짜가 아닙니다. 편향을 줄이는 대신 분산이 늘어납니다. 무조건 보정하는 게 정답은 아닙니다. |
실무에서 자주 걸리는 포인트
- 잭나이프 분산은 대체로 약간 과대추정(보수적) 되는 경향이 있어, 신뢰구간이 다소 넓게 나옵니다.
- n이 너무 작으면(예: 10 미만) 복제값 변동 자체가 불안정합니다.
- 반대로 n이 아주 크고 통계량 계산이 무거우면, n회 재계산 비용이 오히려 부트스트랩보다 클 수 있습니다.
- 공공 마이크로데이터를 분석할 때는 제공된 replicate weight를 그대로 쓰는 것이 원칙입니다. 직접 잭나이프를 돌리면 설계 정보가 반영되지 않습니다.
✅ 그래서 뭘 쓰면 되나 — 선택 가이드
| 상황 | 추천 |
|---|---|
| 통계량이 평활하고 n이 중간 규모, 재현성이 중요 | 잭나이프 |
| 중앙값·분위수 등 비평활 통계량 | 부트스트랩 또는 delete-d 잭나이프 |
| 정밀한 신뢰구간이 필요 | 부트스트랩 BCa (내부에서 잭나이프 병용) |
| 특정 관측치가 결과를 좌우하는지 확인하고 싶다 | 잭나이프 (복제값 분포를 직접 보기) |
🎉 정리
핵심만 다시 짚으면:
- ☑ 관측치를 하나씩 빼며 통계량을 n번 다시 계산한다
- ☑ 복제값의 쏠림으로 편향을, 흩어짐으로 분산을 추정한다
- ☑ 분산 공식 앞의 (n−1)/n 은 표본이 겹쳐서 줄어든 변동을 되돌리는 보정 계수
- ☑ 평활 통계량에서만 쓴다 — 중앙값에 쓰면 틀린다
- ☑ 더 넓게 쓰려면 부트스트랩, 정밀한 구간이 필요하면 BCa
재표본추출은 "데이터를 더 못 모을 때 가진 데이터를 더 짜내는 기술"입니다. 그중 잭나이프는 가장 단순하고, 가장 빠르고, 무엇보다 왜 그 값이 나왔는지 눈으로 확인할 수 있는 방법입니다. 복제값 n개를 그냥 한번 찍어보는 것만으로도, 내 추정값이 어떤 관측치에 매달려 있는지가 바로 보입니다.
- Total
- Today
- Yesterday
- 전자금융기반시설취약점분석평가
- 보안상식
- mcp 서버
- 해킹주의
- AI모의해킹
- 랜섬웨어
- 취약점 분석평가
- 보안뉴스
- 공급망공격
- 취약점
- 개인정보보호
- 악성코드
- 정보보안
- 오픈소스보안
- 해킹예방
- AI보안
- PentestGPT
- 개인정보유출
- 자율침투테스트
- 전자금융기반시설
- AI 모의해킹
- 개발자보안
- 금취분평
- 사이버보안
- 선박사이버보안
- cve
- sast
- DevSecOps
- 펜테스트
- 시큐어코딩
| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | ||||
| 4 | 5 | 6 | 7 | 8 | 9 | 10 |
| 11 | 12 | 13 | 14 | 15 | 16 | 17 |
| 18 | 19 | 20 | 21 | 22 | 23 | 24 |
| 25 | 26 | 27 | 28 | 29 | 30 | 31 |